
文献管理技巧大全,助科研人高效整理海量文献
硬盘里躺着三百篇PDF,写论文时想找那篇讲“细胞焦亡与肿瘤微环境”的,翻了三十分钟没翻到。最后凭记忆去数据库重新下载了一遍。
这种事,经历过的人都懂。问题不在文献多,在于存进去的那一刻就没管好,今天就告诉你文献管理技巧。
一、文献规范入库下载
优先使用文献管理工具批量抓取文献:利用浏览器插件,在数据库页面一键导入文献,自动抓取题录信息(作者、标题、期刊、DOI等),减少手动录入产生的错误。
文献信息校验:自动抓取的数据偶尔会存在缺失、拼写错误,文献入库时简单核对基础信息,补全DOI、发表年份等关键字段。
做好文献初筛,拒绝盲目囤积:下载文献之后先快速判断相关性,低相关文献不必入库。无差别保存所有文献,会造成文献库臃肿,检索效率持续下降。
二、文献库分类体系与工具辅助
入库完成后,搭建合理的分类体系,是文献管理最关键的一步,两种方式搭配使用:
(一)文件夹分组
适合大方向划分,例如按照课题方向、文献类型(综述/研究论文)建立一级文件夹,做宏观归类。缺点是一篇文献只能归入单个文件夹。
(二)标签体系(推荐重点使用)
标签可以多维度标记单篇文献,例如:研究热点、实验方法、高被引、待精读。同一篇文献可以打上多个标签,后续可以通过标签筛选,突破文件夹单一分类限制。
实操小技巧:提前规划标签命名规则,不要随意新建零散标签,防止标签泛滥。
选对工具能大幅降低管理负担,Zotero、小绿鲸、EndNote三款工具是我一直都在用的,可以说用这三款足够了。
(一)Zotero
Zotero的核心是:浏览器里看到什么,一键存什么。
核心亮点在抓取能力。Chrome、Firefox、Safari都装了Connector插件后,PubMed页面点一下图标,题录和PDF一起进库。知网也能抓,但要装茉莉花插件优化中文元数据识别。PDF拖进软件也会尝试识别标题作者,但准确率不稳定,重要文献建议手动核对。
标签系统是Zotero真正的管理武器。文件夹按“项目”分,标签按“特征”打。一篇论文可以同时存在于“毕业论文”文件夹里,带着“关键方法”和“待精读”两个标签。找的时候按文件夹定位项目,按标签筛选特征,比纯文件夹灵活得多。
插件生态决定了它的上限。Zotero装完本体只是个空壳,功能全在插件里。做划词翻译,强化笔记系统,优化中文文献识别,显示期刊分区影响因子装了插件以后都可以。不装插件的话,它就是个能抓网页的PDF仓库。
短板也在这里。插件装多了可能冲突,每个插件都有自己的设置界面,新手容易迷失。同步空间免费只有300MB,文献多了得配WebDAV或者坚果云。
(二)小绿鲸
小绿鲸其实是全能选手,可以在里面检索文献、管理文献、阅读文献等。
上传PDF之后,软件会自动提取文献题录,同时抓取期刊分区、影响因子等附加信息,省去手动查询的麻烦。支持文件夹搭建文献库,搭配标签、星级标记来区分文献优先级,快速筛选核心必读文献。
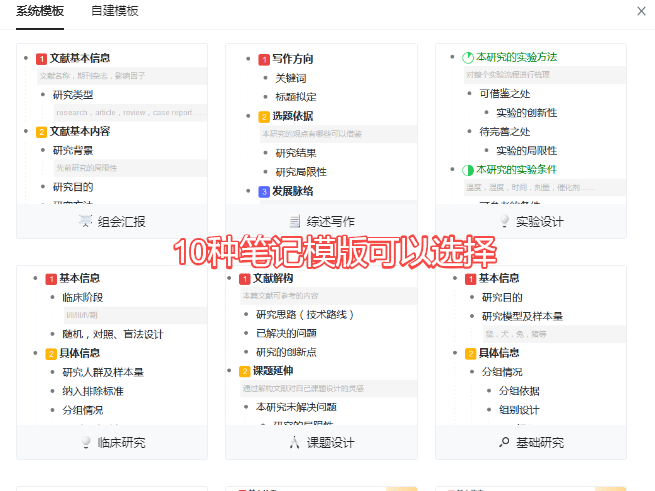
自带云端同步,电脑、网页端、平板之间文献库、标记信息实时互通。它还可以和Zotero联动,直接导入Zotero文献库,在小绿鲸内打开Zotero的文献,一边管理文献一边完成外文精读。笔记功能是亮点。内置10+科研场景笔记模板(组会汇报、实验模版等)直接套用。
(三)EndNote
老牌文献管理软件,高非常适合课题组协作以及SCI期刊投稿引文管理。
内置上万种期刊引文格式模板,覆盖绝大多数SCI期刊、学位论文格式。支持分组管理文献,可以创建普通分组和智能分组,设置筛选规则之后,新入库文献会自动归入对应的智能分组,自动完成归类。
自带在线检索入口,可以直接在软件内检索学术数据库,批量导入文献。文献库支持多人共享,课题组可以共用一套文献库,设置不同权限查看、编辑文献条目,很适合团队科研。自带查重识别,批量导入文献自动识别重复文献。
软件内置在线检索面板,输入关键词检索数据库,直接选中文献导入库;也可以从数据库导出题录文件批量导入,或者拖拽本地PDF添加条目。新建分组对文献归类,设置智能分组规则,例如限定年份、期刊主题,满足条件的文献自动归入分组。
三、文献库日常维护管理
文献库不是一次性建好就可以置之不理,定期维护才能长期保持高效。
定期清理冗余文献:每隔一段时间,重新评估库内文献。课题结束或者方向调整后,把不再需要的文献归档或者移出主库,减轻库负担。
文献库备份机制:这一步极易被忽略。定期对整个文献数据库备份,可以本地备份或者云端备份,防止电脑损坏、软件异常导致全部文献资料丢失。
版本管理:同一篇文献如果有预印本、正式发表版本,在条目备注中标注版本信息,避免混淆不同版本论文。
文献管理说到底,管的是“你下次能不能找回来”。下载时多花十秒确认信息,分类时多想一步“我以后会怎么找它”,维护时每周花五分钟扫一遍。省下来的时间,够你多读两篇论文。