
文献管理AI工具做标签、分组、知识库实操,完整工作流分享
很多人用文献管理ai工具,只用来读PDF、生成摘要,标签和分组还是手动瞎整理。标签、分组、知识库三者是一套连贯流程:标签是细粒度索引,分组是宏观归类,知识库是把文献、笔记、观点串联起来的整体。
下面分享一套我用文献管理ai工具——小绿鲸,帮我实现完整文献管理工作流。
一、分清标签、分组、知识库三者分工
(一)分组:大分类,偏向课题方向、研究模块,数量不宜过多,相当于文件夹。适合用来划分大主线,比如材料体系、表征方法、理论模拟,同一篇文献归属同一个分组。
(二)标签:细粒度标记,属性关键词,一篇文献可以挂多个标签。比如:高被引、机制研究、阴性结果、综述。方便跨分组检索筛选。
(三)知识库:是最终载体,不是单纯文献库。整合文献原文、自己的批注、观点对比、实验数据笔记,形成属于你课题的知识网。
二、文献管理进阶工作流
(一)入库清洗:文献进来先把关
很多人批量拖入PDF之后直接开始阅读整理,忽略题录核对,等到写论文插入引文,才发现作者、卷期、DOI信息识别出错,返工非常耗时间。
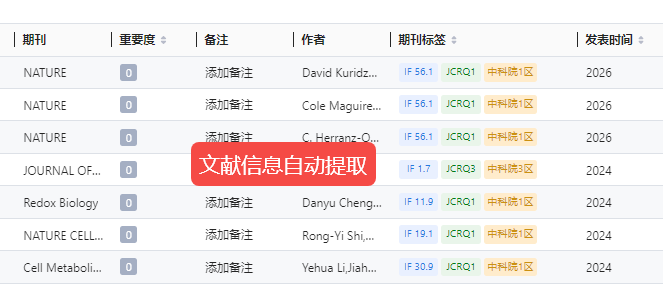
在小绿鲸上传PDF,她就会自动解析提取题录,自动带出期刊、JCR/中科院分区、发表年份,识别不准的条目可以直接手动修改保存,不用一条一条手动录入。今年是支持一键从Zotero导入整套文献库,原来建好的题录、自建标签可以同步迁移,原有分类结构保留,导入之后直接接着继续整理,实现又管又读文献。
(二)分类体系搭建:文件夹做大归类,标签做多维度检索
不少新手会把文件夹和标签混为一谈,文件夹建得细碎,或者完全不打标签,后期筛选文献只能一页页翻列表,上千篇文献根本调不动。文件夹适合固定的大方向收纳,标签用来横向交叉检索,二者搭配才最高效。
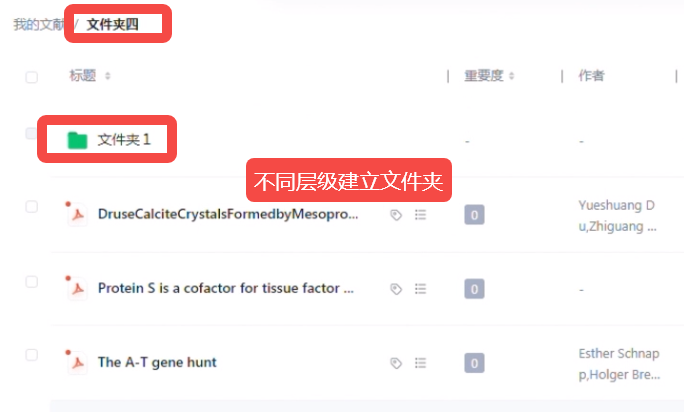
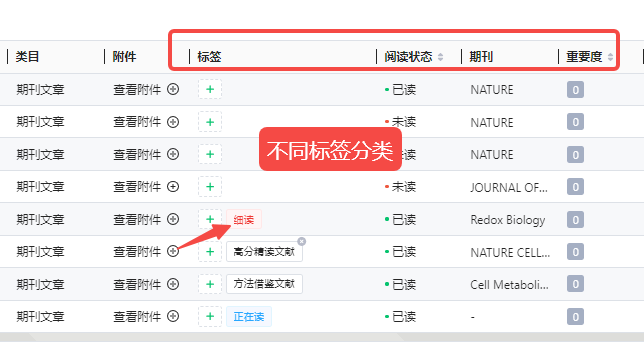
小绿鲸支持不同层级创建文件夹,用来做大方向归类;自定义彩色标签,单篇文献能够挂载多个标签,支持标签组合筛选检索;标签会和高亮批注、阅读笔记绑定。文件夹和标签两套体系分开配合,文件夹做宏观收纳,标签负责细节分类,互不干扰。
自带阅读状态记录,快速标注未读、粗读、精读、归档,还能按照阅读进度筛选文献,方便规划自己的文献阅读任务。
(三)精读批注:笔记和原文绑定
很多同学习惯单独开Word记阅读感想,隔上半个月回头看笔记,完全想不起来这段话对应原文哪个位置,还要重新翻PDF找段落,阅读笔记基本失去价值。
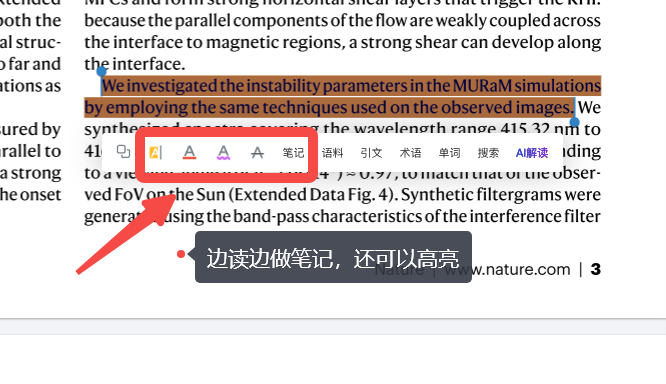
小绿鲸自带内置PDF阅读器,鲸灵AI大模型匹配113个学科翻译,阅读过程中直接在原文上高亮、写批注;摘要、创新点、研究局限这些笔记直接挂载在本篇文献下面,原文和笔记绑定存放。
(四)长期沉淀:搭建课题专属知识库
课题周期往往两三年,持续不断有新文献补充进来。单纯存PDF算不上知识库,真正的知识库,是把多篇文献的观点、冲突、待解决问题串联起来,为开题、综述、实验设计持续提供支撑。
独立知识库笔记模块,可以跨多篇文献互相建立关联引用,长期沉淀课题脉络、待解决的科学问题、潜在创新思路,不止是存放文献PDF。电脑、平板来回换设备看文献也没事,云端同步,两端的文献库、高亮批注、标签、知识库笔记实时更新,任意设备打开都是最新整理后的版本。
三、这套文献管理工作流要避开这些坑
(一)不做人工校准,标签五花八门,同义词泛滥,后期检索失效;
(二)文件夹和标签功能重复,细碎文件夹一大堆,分类逻辑混乱,检索困难;
(三)知识库只存放PDF,不写批注、不做观点对比,本质只是网盘文件夹,没有知识沉淀;
(四)一次性导入几百篇文献,不做初筛,无关文献混入,AI提取信息、生成标签质量大幅下降;
用小绿鲸跑这套流程的好处,就是文献存储、阅读翻译、标签分组、笔记知识库、引文插入在一个工具闭环,但是说到底,AI只是提速工具,标签、分组、知识库的骨架,必须贴合你自己课题的逻辑。