
SCI统计分析教程:从数据预处理、假设检验到图表报告详细攻略
很多同学做课题,精力全放在做实验、攒数据上,统计环节草草收尾,最后栽在方法学上。审稿人看统计,不是只看星号是否显著,而是整套链路能不能自洽:数据处理有没有依据、检验前提是否满足、结果报告是否规范、图表能不能支撑结论。
这篇顺着完整实操流程拆解,并说明sci统计分析底层原则,快来一起学习吧。
一、SCI统计分析的底层原则
(一)统计方案要在实验设计阶段提前定好,不能拿到数据之后反复试不同检验方法,挑显著的结果上报,属于P-hacking;
(二)显著性≠实际意义,P值只是统计推断参考,不能单靠星号下强结论;
(三)所有数据剔除、转换、校正操作,后续Methods里都必须写明理由,不能隐性处理。
新手处理起分析数据很容易出错,整套链路也很难自洽,所以我推荐可以用小绿鲸的统计分析工具,选择研究领域,输入研究目的和类型,把数据一上传,小绿鲸就会结合海量SCI文献与科研数据,提供统计分析依据。
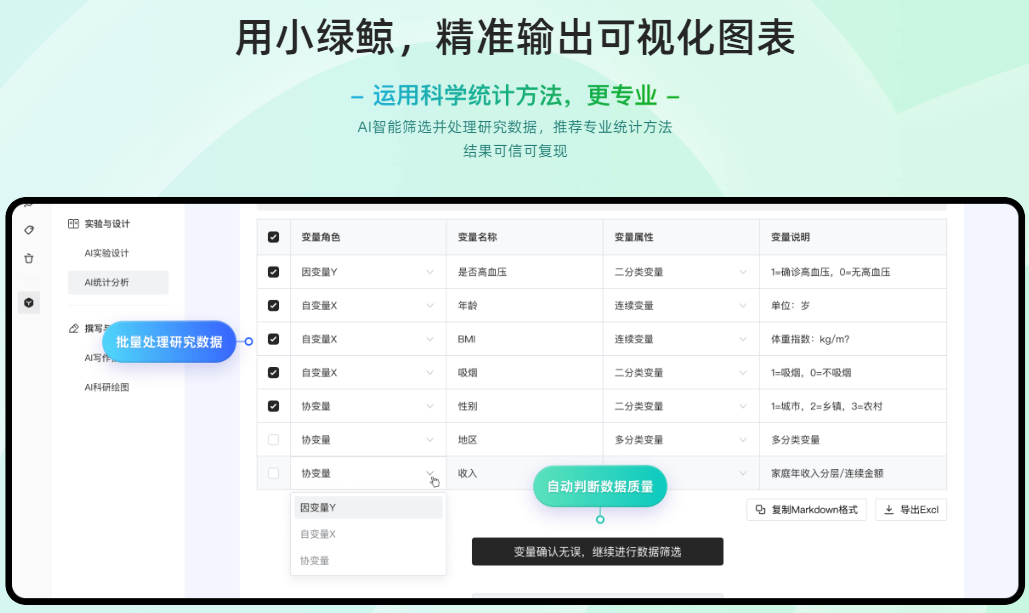
鲸灵AI科研大模型基于科研数据与统计方法,AI理解研究问题与数据特征,输出完整分析流程、统计方法及可视化图表。支持影响因素分析、相关性分析等12+研究类型,自动选择最优分析模型,生成更符合实际需求的统计分析方案。
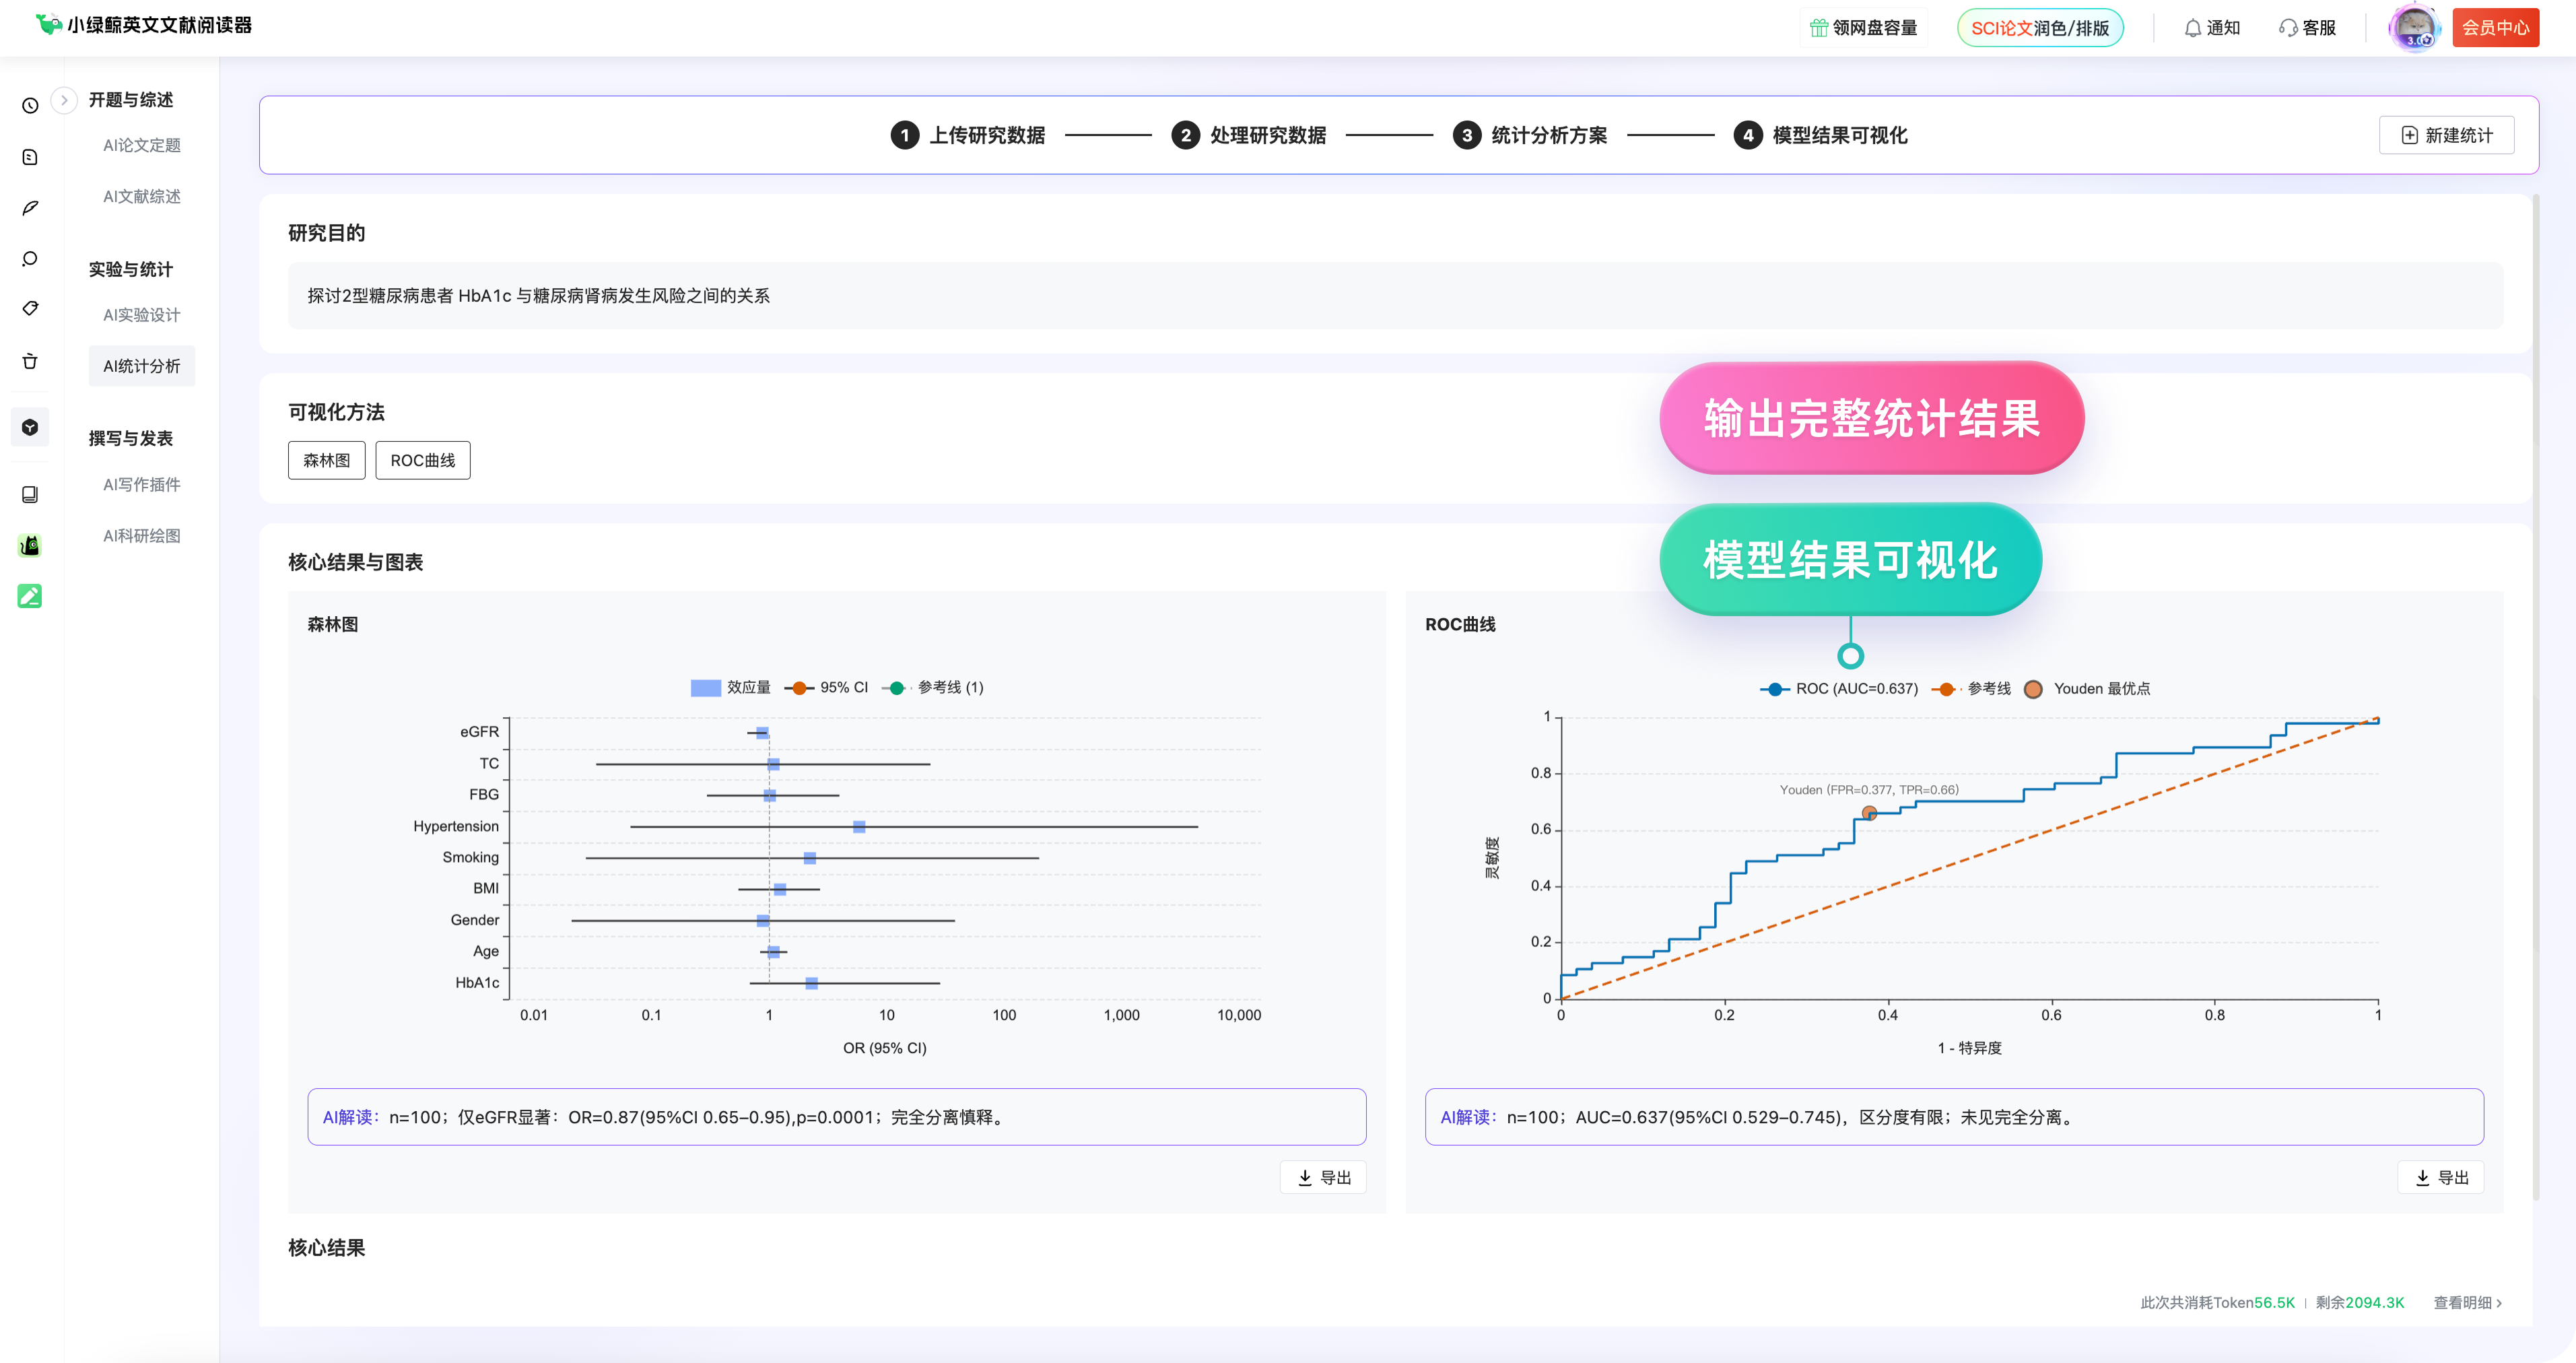
基于权威统计方法与检验规范,AI智能筛选并处理研究数据,推荐专业统计方法,输出可解释、可复现、可发表的统计分析结果。比如这个方向做细胞实验一般用什么检验、多组对比选哪一种校正、大家习惯写SD还是SEM、常规的样本数量大概是多少。不用你自己一篇篇慢慢翻、一点点摘抄。
二、第一步:原始数据预处理
(一)原始数据归档与录入
原始数据留存、编号,区分生物学重复和技术重复,做好标注,避免后期混淆伪重复;表格规范,避免合并单元格、文本混杂。
(二)缺失值处理
区分缺失类型:随机缺失、非随机缺失;简单删除、均值填充都有适用边界,不能直接删掉所有带缺失的样本不做说明;临床样本这块要求更严格。
(三)异常值识别与处置
箱线图、Z-score识别离群点;重点:不能看见异常值直接删掉。先核查是不是仪器、操作失误导致的记录错误;确认是真实样本差异,就要保留数据,或者说明剔除依据,必要时补充敏感性分析。
三、第二步:假设检验选型与实操
(一)两组比较
独立样本t检验/Welch t检验、配对t检验;非正态时换Mann‑Whitney U、Wilcoxon配对检验;区分单侧、双侧检验,提前设定α=0.05,文中写清楚。
(二)多组比较
单因素ANOVA、双因素ANOVA;ANOVA得到组间有差异,才做事后两两比较(LSD、Tukey、Dunnett等);必须校正多重比较(Bonferroni、FDR),不校正会放大假阳性,是审稿高频提问点。
(三)相关性、回归类分析
Pearson(正态连续)、Spearman秩相关;线性回归、逻辑回归;区分相关性和因果关系,不要过度解读。
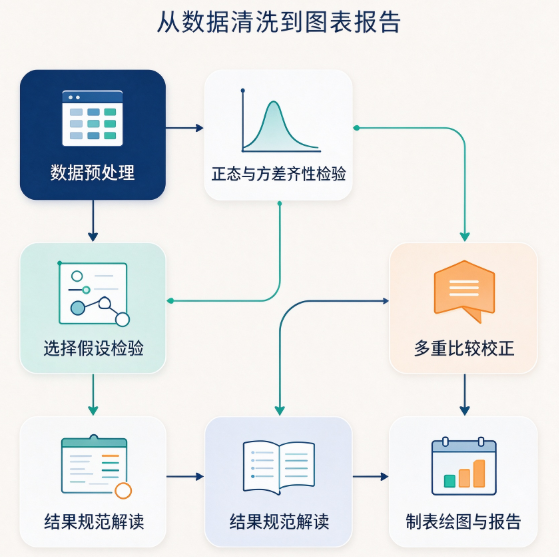
四、第三步:统计结果规范解读
(一)P值报告:优先给出精确P值,不要只写P<0.05;P<0.0001统一规范写法;提前约定显著性标记规则,图注统一说明;
(二)集中趋势和离散指标:正态数据用均值±SD;偏态数据用中位数+四分位数;分清SD(样本离散度)和SEM(均值标准误),很多期刊不推荐滥用SEM;
(三)效应量、置信区间:高分期刊越来越要求配套报告,不只依赖P值;
(四)阴性结果处理:如实汇报,不要刻意隐瞒不显著的对比,也不要强行解释成“有趋势”。
SCI统计分析需要整套流程透明、有据可查,别人可以重复你的分析过程。小绿鲸可以帮科研新人快速对标领域惯例、降低信息检索成本,但它只是辅助工具,数据分布核验、最终方案敲定,都需要研究者自己把控。